En 2018, unos psicólogos sentaron a varias personas ante una pantalla sembrada de puntos y les pidieron una sola cosa: que fueran señalando los azules. Sin avisar, los investigadores fueron retirando puntos azules, y los participantes empezaron a llamar azules a los morados. Con caras pasó igual: cuando escasearon los rostros amenazantes, los neutros se volvieron amenazantes. Con juicios morales, otra vez lo mismo: cuando escasearon las peticiones abusivas, las inocuas pasaron a parecer poco éticas. Avisarles de antemano no cambió nada. Pagarles por mantener el criterio, tampoco. El experimento es de Levari y colegas, y salió en Science; la idea la había formulado Helson sesenta años antes. Nadie mide con un patrón absoluto: se mide con lo último que se ha visto.
Ahora un pájaro. Tinbergen le puso a un ostrero un huevo falso, más grande que el suyo y con el moteado más regular, y el ostrero abandonó el propio para empollar aquel. No se le había roto nada por dentro. Su instinto hacía exactamente lo que debe hacer un instinto: elegir lo que más se parece a un huevo. Lo que pasa es que, hasta que alguien fabricó uno a propósito, nada en el mundo se parecía a un huevo más que un huevo. Tinbergen descubrió el siglo pasado que el señuelo exagerado derrota siempre al estímulo natural, y le puso nombre: estímulo supranormal. Las máquinas de las que trata este artículo se dedican a poner esos huevos.
Decenas al día, uno a la medida de cada cual, gratis.
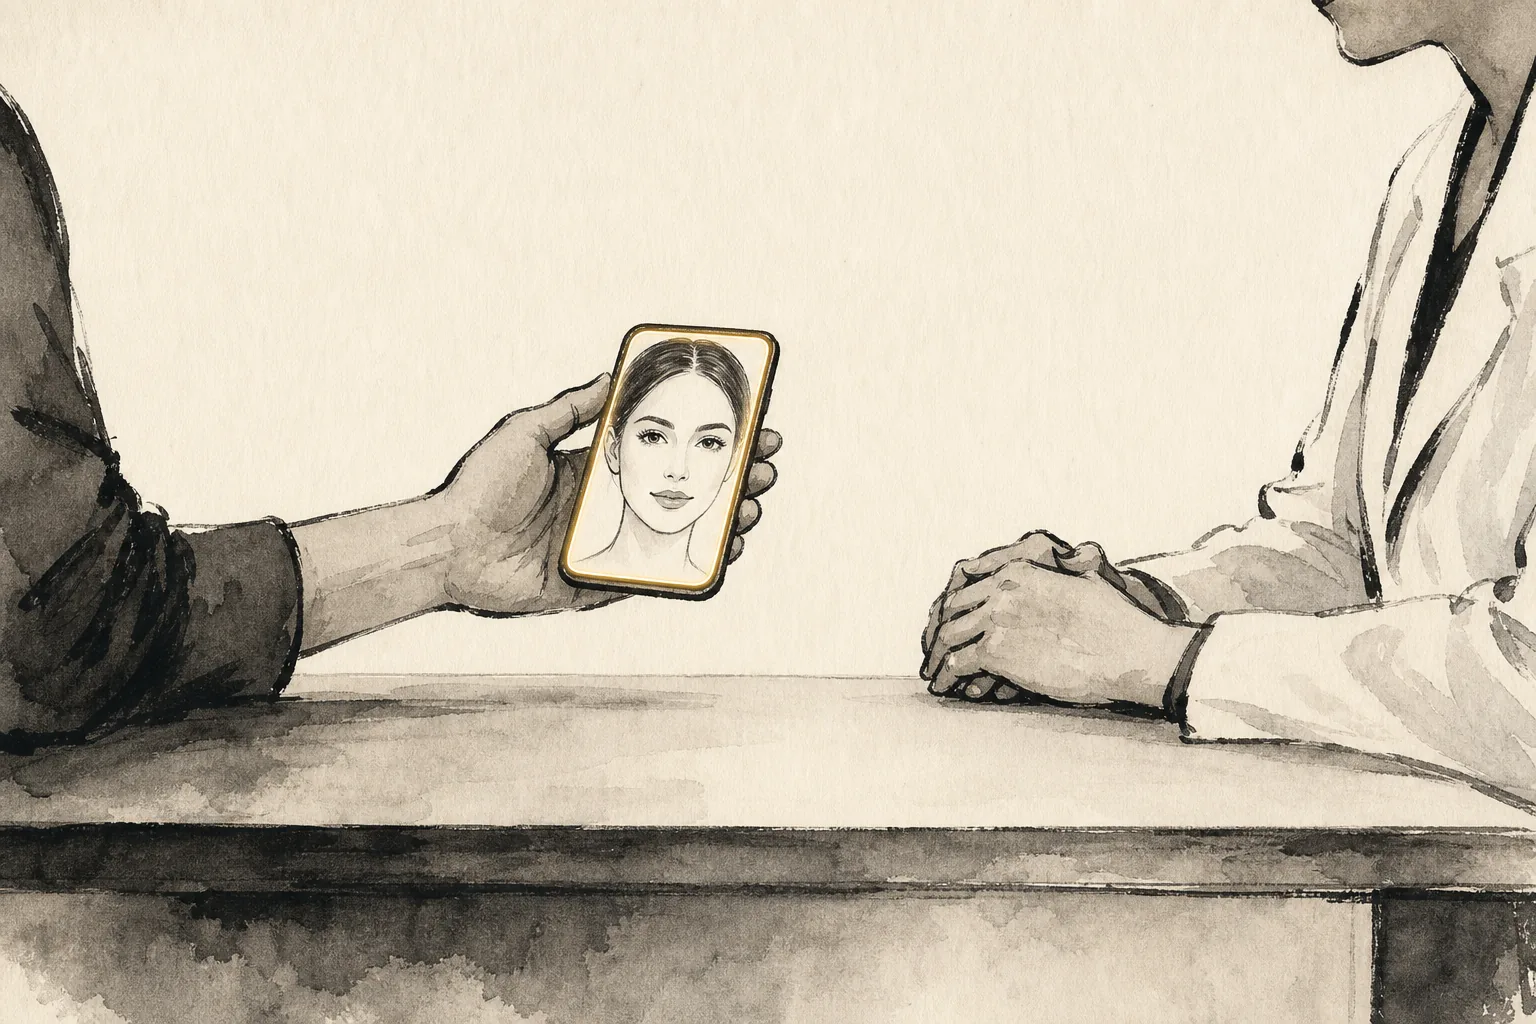
Cambie el punto azul por una cara y el huevo falso por una conversación. El selfi retocado que duerme en el carrete del móvil tiene la piel más lisa que la del espejo; el asistente que sigue contestando a las tres de la madrugada tiene más paciencia que cualquiera de las personas que uno tiene cerca. Nada de eso se entrega como producto terminado. Su utilidad consiste en servir de comparación, y la comparación es larga, frecuente y prácticamente gratuita. Las consultoras de clínica describen esta escena: la paciente le pasa el móvil por encima de la mesa, en la pantalla está ella misma retocada por una IA, y la pregunta ya no es qué quiere usted, sino si esa cara es físicamente posible.
De tanto comparar, lo más liso, lo mejor y lo que menos esfuerzo cuesta acaba asentándose como lo normal, y lo normal es el punto de partida desde el que cada uno puntúa a los demás. A esa clase de cosas le hemos puesto un nombre: aplicaciones de IA de condicionamiento cognitivo, en inglés Cognitive-Conditioning AI Applications, CCAA. No es lo mismo que la sustitución. La sustitución cambia quién hace el trabajo; el condicionamiento cambia hasta dónde hay que llegar para que el trabajo se considere normal. Cambiada la vara, cambian con ella lo que el cliente pide, lo que está dispuesto a pagar y el cansancio con el que termina el día quien hace el trabajo.
Nada de esto aparece en una carta de despido ni entra en las cifras de paro. Un puesto puede seguir intacto, y las tareas también, mientras la vara con la que lo miden el paciente, el cliente, el alumno o la familia se cambió anoche en un teléfono. De modo que preguntar si la IA sabe hacer un trabajo cubre solo la primera mitad del problema. Todos los instrumentos que hoy miden el impacto de la IA miden esa primera mitad. La segunda no la mide nadie. La caja de herramientas está llena y ninguna sirve para eso.
La mitad que nadie mide
El mercado de trabajo ya devuelve los primeros ecos. En una plataforma de trabajo autónomo, los ingresos mensuales de las ocupaciones muy expuestas cayeron alrededor del 5,2% tras la aparición de ChatGPT, sin ninguna evidencia de que un buen historial protegiera a nadie.[1] Entre los trabajadores de 22 a 25 años hay un déficit relativo de empleo de en torno al 19% en las ocupaciones más expuestas frente a las poco expuestas de la misma edad, y el mecanismo es que se contrata menos, no que se despida más; los propios autores lo llaman «indicadores descriptivos tempranos, no estimaciones causales».
En atención al cliente el signo se invierte: un asistente de IA elevó los casos resueltos por hora un 14% de media, un 34% entre los novatos y casi nada entre los veteranos que ya rendían bien. Lo que la máquina levanta es el suelo.[2]
Conviene, eso sí, no tratar ChatGPT como un experimento natural limpio. En 2026, Frank y colegas cruzaron registros administrativos del seguro de desempleo con millones de perfiles de LinkedIn y encontraron que el riesgo de desempleo en las ocupaciones expuestas empezó a subir a principios de 2022, meses antes del lanzamiento. En la debilidad posterior a 2022 hay política monetaria y reajuste sectorial pospandemia, cosas que poco tienen que ver con lo que sabe hacer un modelo.
La mitad de la sustitución existe, es pequeña y ya hay quien la mide. La estimación más citada es la de Eloundou y colegas en Science: contando solo los grandes modelos, alrededor del 1,8% de los empleos tiene más de la mitad de sus tareas afectadas; si se suma el software complementario, la cifra pasa del 46%. Cambiada la definición, la respuesta se multiplica por veinticinco, y el lugar exacto por donde se abre esa horquilla dice qué se está midiendo: si la tarea puede ejecutarse técnicamente. Al lado están el indicador AIOE de exposición por capacidades, de Felten, Raj y Seamans, y el documento de trabajo de Webb, todavía sin publicar, que miden lo mismo.[3] Ninguno tiene una variable que responda a quién arbitra si el trabajo está bien hecho. Ni AIOE, ni Webb, ni Eloundou. Desde el primer día contestan a otra pregunta. Quién asiente cuando el trabajo está terminado, y de dónde ha sacado su vara el que asiente: eso no tiene casilla en el instrumento.
La economía convencional rozó este eje una vez. Acemoglu sitúa el efecto de la IA sobre la productividad total de los factores a diez años en no más del 0,71%, y por debajo del 0,55% al incorporar las tareas difíciles de aprender, y su razón declarada es que en esas tareas hay «muchos factores dependientes del contexto que afectan a la decisión y ninguna medida objetiva de resultado de la que aprender un desempeño exitoso». Eso es casi exactamente el segundo eje que buscamos, salvo que él lo usa para concluir que la IA sirve menos y nosotros para preguntar quién está protegido. David Autor lo dice más directamente: la barrera que rodea al trabajo experto es la licencia y la responsabilidad, no la dificultad de la tarea.[4]
Dos condicionamientos
Para que el nombre sirva de algo hay que recortarle antes lo que no le corresponde; si no, se lo traga todo. La definición cabe en una frase, se lee algo dura y cada uno de sus adjetivos está ahí para dejar fuera una clase de fenómeno que no debería contar. El primero de todos: las salidas de IA que sí se entregan como producto terminado.
Aplicaciones de IA de condicionamiento cognitivo (CCAA): clase de aplicaciones de IA cuya salida no se consume como producto terminado, sino que el usuario la adopta como marco de referencia. Bajo una exposición prolongada, de alta frecuencia y con coste marginal cercano a cero, las propiedades estadísticas de esa salida (media mejor, varianza menor, menos fricción) se interiorizan como lo «normal» y reescriben el umbral de expectativas que la persona aplica a la realidad.
El problema es que «condicionamiento» quiere decir dos cosas, y mezclarlas invalida el argumento entero. Una crece del lado de la compra: el comprador reajusta lo que espera en precio, volumen, plazos y número de revisiones. El caso típico es la redacción publicitaria, donde «una campaña» significa hoy cuarenta variantes en una noche a coste marginal cero. Eso es un fenómeno de mercado —inflación de estándares empujada por los costes—, lo explica entera la competencia de precios y no hace falta ningún concepto nuevo. La otra crece del lado de la percepción: la persona reajusta su línea base sobre cómo deberían ser una cara, una conversación, una pareja, un cuerpo. Eso es un fenómeno psicológico, y CCAA se refiere únicamente a él. La exclusión trae consigo una consecuencia incómoda. La redacción, la ilustración genérica y el vídeo de plantilla son los sectores que a casi todo el mundo le vienen a la cabeza al pensar en el impacto de la IA, y son precisamente donde la tesis no es identificable: allí el estándar se movió y cambió el proveedor a la vez, de modo que nada puede atribuirse al condicionamiento porque la competencia de precios ya lo explica todo. La evidencia limpia solo aparece donde la persona sigue haciendo el trabajo y aun así el estándar se movió: medicina estética, terapia, enfermería, docencia. Por eso, de aquí en adelante, los ejemplos de redacción aparecen como ilustración y nunca como prueba.
El nombre es nuestro y se publica por primera vez el 1 de septiembre de 2026. «Condicionamiento» se usa aquí en su sentido coloquial, no en el del aprendizaje asociativo de la psicología; y las cuatro letras de CCAA designan en Canadá una ley concursal, de manera que como término de búsqueda son casi inservibles: en textos formales, escríbase completo.
Nada de esto es nuevo
Ni una pieza de esto es nueva. El experimento de los puntos azules tiene un linaje largo detrás. La teoría del nivel de adaptación de Helson dice que todo juicio se emite tomando como vara un punto de referencia que agrega la distribución reciente de estímulos; la teoría de rango-frecuencia de Parducci formaliza cómo la media y la varianza fijan el umbral; la adaptación hedónica de Brickman y Campbell sostiene que una media mejor se convierte en el nuevo punto de partida y la satisfacción vuelve a su sitio; más allá quedan la comparación social de Festinger, de 1954, la teoría del cultivo de Gerbner y los estímulos supranormales que hay detrás del ostrero del principio. En conjunto, esa literatura cubre ya toda la afirmación mecanicista de CCAA; no sostenemos haber descubierto ningún mecanismo psicológico nuevo.[5]
Hay que declarar además que el experimento del principio solo cubrió una mitad. Levari y colegas trabajaron el lado de la escasez: al ralear los puntos azules, el concepto de azul se ensancha. Lo que nosotros necesitamos es el contrario, el de la abundancia: cuando abundan las caras buenas, las respuestas buenas y los textos buenos, el listón de lo bueno sube. La teoría del punto de referencia es simétrica en principio, pero los experimentos publicados corrieron solo en aquel sentido. Esa simetría es una hipótesis, no un hallazgo. Contrastarla no es difícil: basta con recorrer el mismo paradigma al revés.
De ese mismo linaje sale, sin ningún esfuerzo, la objeción más seria contra nosotros. Uno de los resultados centrales de la literatura sobre adaptación hedónica es que la adaptación es ampliamente simétrica y reversible. La alegría de una subida de sueldo vuelve al punto de partida: la cinta corre, pero el corredor no se mueve del sitio. Según eso, quien se acostumbra a las caras retocadas por IA volverá, al cabo de un tiempo, a acostumbrarse a las de siempre. Si el condicionamiento no es más que adaptación hedónica con otro nombre, sus predicciones económicas fallan de una forma muy concreta: el umbral sube y a la vez la insatisfacción se atenúa, de modo que la demanda no migra de forma duradera hacia la medicina estética. No rebatimos la objeción.
La respuesta consiste en estrechar la afirmación de persistencia. Las personas se readaptan; las instituciones no. Una vez que el estándar desplazado se escribe en una rúbrica de contratación, en la galería de antes y después de una clínica, en la norma fotográfica por defecto de una plataforma, en una plantilla de evaluación del desempeño o en un criterio de suscripción de seguros, queda fijado. La galería es el caso más visible. El «después» que se colgó el año pasado, si venía ya retocado con ayuda de IA, es la cara que el año que viene traerá en la cabeza quien cruce la puerta; nadie recordará en qué año y con qué fotografía empezó la línea, pero la fotografía sigue en la pared, con su fecha. La virtud de estos rastros es justamente que se pueden medir: son registros institucionales, están archivados, llevan fecha y se pueden contar uno a uno. El condicionamiento produce consecuencias económicas duraderas solo allí donde el estándar desplazado queda codificado en una institución.
El espejo empieza a contestar
De genuinamente nuevo queda una sola cosa: generar una muestra mejor cuesta ya cero. A partir de ahí el espejo contesta, y contesta a una persona en concreto. Lo primero que se sigue de eso es que el estímulo idealizado se fabrica por individuo. Los medios de difusión producían un ideal y se lo mandaban a todos, y cualquiera veía que estaba preparado para otro; el de la IA generativa se genera optimizado para las reacciones de esta persona en este momento, y encima responde. La literatura sobre comparación social sitúa la contingencia —es decir, que el otro responda a lo que uno hace— entre las variables que impulsan la interiorización, y una portada de revista no le respondió nunca a nadie: está colgada ahí, igual para todos. Lo segundo es más íntimo: el conjunto de referencia incluye ahora la imagen idealizada del propio usuario. Los filtros y los selfis generados con IA reducen a cero la distancia de comparación, y el término de comparación deja de ser una celebridad para ser una versión mejor de uno mismo, con los mismos huesos, los mismos lunares y la ropa de ayer, solo que con la piel mucho más limpia. Una misma persona puede recibir en un día decenas de muestras optimizadas para ella, y esa cifra, por sí sola, se puede contar.
Lo que queda desmontado es la condición que hace funcionar a la teoría del cultivo. El cultivo presupone un entorno simbólico compartido, difundido y no electivo, y es justamente esa condición compartida la que produce el mainstreaming, la convergencia de las visiones del mundo hacia el centro televisivo. La IA generativa suministra una distribución personalizada, bajo demanda, ilimitada y dirigible por el usuario. El paso no consiste en cambiar de medio, sino en romper la condición generadora de la teoría. De ahí sale una predicción falsable: lo que se predice es divergencia normativa, no normalización mayoritaria. Si en la próxima década se observa convergencia en estética, lenguaje y expectativas relacionales, esta distinción central del artículo es errónea.
Tres mecanismos
Dos memorandos
El primero es la asimilación del registro. Un mismo asunto, dos memorandos, dos maneras de decirlo:
- «A continuación, dos asuntos que requieren su decisión.»
- «¿Le echas un ojo a estos dos?» / «Perdona la lata, ¿puedes decidir tú estos dos?» / «Estos dos necesitan tu firma.»
Las dos son igual de profesionales; lo que las separa es la presencia o la ausencia de marcas de identidad. El registro transporta información relacional: quién habla con quién, qué relación tienen, cuánta urgencia hay de verdad, cuánto favor se está pidiendo. El jefe que lee la primera frase sabe que hay dos asuntos pendientes; el que lee la segunda sabe además hasta qué punto tiene confianza con quien escribe y con cuánta prisa se lo están pidiendo. Las herramientas de escritura con IA están cambiando lo segundo por lo primero, un registro institucional neutro.
El daño de verdad llega en el segundo tiempo. Si tres peticiones salen pulidas de idéntica manera, el jefe no distingue cuál corre prisa de verdad y termina convocando a los tres a una reunión. Se ahorran palabras, no trabajo. El coste total de comunicar no baja: se traslada del lenguaje al procedimiento y reaparece en forma de una reunión más, un plazo adelantado y una lista de copia más larga.
En el laboratorio la causa ya se ha visto. Jakesch y colegas pusieron a unas mil quinientas personas a escribir con la ayuda de un modelo de lenguaje sesgado: lo escrito se desplazó hacia la postura del modelo y las actitudes que los propios participantes declararon después se desplazaron con él, algo que los autores llaman «persuasión latente». Ellos mismos advierten que la opinión del modelo se hizo fuerte a propósito, que el tema tenía poco arraigo y que el desplazamiento actitudinal era probablemente transitorio.[6] Lo mismo, ampliado a todo un corpus académico, sigue estando ahí. Kobak y colegas peinaron más de 15 millones de resúmenes de PubMed y detectaron, mediante frecuencias léxicas en exceso, un salto brusco a partir de 2022: al menos el 13,5% de los resúmenes de 2024 pasó por un LLM, con picos del 40% en algunos subcorpus, un cambio mayor que el que la COVID produjo en la escritura académica. Liang y colegas peinaron cerca de un millón de artículos y estimaron hasta un 17,5% de texto reescrito en informática.[7]
Y ahora entre dos personas. Los dos experimentos aleatorizados de Hohenstein encontraron que las respuestas inteligentes (esas sugerencias de un toque que propone el teléfono) aumentaban la eficiencia y el lenguaje emocional positivo y mejoraban la valoración del interlocutor, pero que en cuanto el otro sospechaba que había IA de por medio, la valoración se volvía negativa.[8] Laboratorio, corpus y conversación apuntan en la misma dirección: aquí la cadena de evidencia es la más completa.
Completa no quiere decir pertinente. Lo que estos trabajos establecen es imitación y difusión, esto es, que el lenguaje converge realmente hacia el estilo del modelo. No establecen que el umbral de aceptación de nadie se haya movido. Imitar y desplazar un umbral son cosas distintas, y el experimento de los textos congelados que viene más adelante existe precisamente para separarlas.
Qué anchura tiene lo normal
El segundo es la sustitución de la distribución. La gente juzga lo normal estimando una distribución a partir de las muestras que ha visto. El contenido generado por IA mueve a la vez dos parámetros de esa distribución: sube la media y comprime la varianza. La compresión es la más insidiosa y la de peores consecuencias, porque lo que borra es la información sobre qué anchura tiene lo normal, que es exactamente la que decide cuántas cosas está uno dispuesto a contar como normales.
La evidencia más sólida a favor no está en la investigación sobre IA, sino en la de adaptación visual. La revisión de Brooks y colegas, de 2020, resume experimentos donde mirar durante largo rato fotografías de cuerpos de un tamaño dado desplaza el punto de normalidad subjetiva del observador, es decir, el lugar donde para él está lo que debe ser un cuerpo normal. El desplazamiento es bidireccional, manipulable experimentalmente y modulado por la atención, y es la mejor versión empírica que existe hoy de la idea de que una distribución fija la norma. Conviene ver su límite: los estímulos eran fotografías, no salidas de IA.[9]
Del lado de la IA, la evidencia directa se reduce a un experimento preinscrito. Doshi y Hauser reunieron a 293 escritores y 600 evaluadores: quienes recibían ideas de IA generativa produjeron textos valorados como un 6,7% más novedosos y un 6,4% más útiles, con las mayores ganancias entre los escritores menos creativos, y a la vez esos relatos se parecían significativamente más entre sí que los del grupo de control humano. La magnitud de ese parecido hay que declararla. La dirección es firme; el tamaño es pequeño.[10]
Un año después alguien hizo un experimento mayor y la conclusión se dio la vuelta. En 2025, Ashkinaze y colegas presentaron en la conferencia ACM de inteligencia colectiva un diseño dinámico encadenado con más de 800 participantes de más de 40 países, en el que cada oleada veía la producción de la anterior. Una exposición alta a la IA no alteró la creatividad individual y en cambio aumentó la diversidad colectiva de ideas y su tasa de cambio. El diseño es mayor y tiene más validez ecológica. Este mecanismo está en disputa, no establecido. Aun así lo conservamos, y la razón es que los dos experimentos de creatividad miden diversidad de la producción mientras que nosotros hablamos de compresión de la varianza: en adaptación visual esa compresión está firme, y en creatividad es muy posible que ni siquiera se esté tocando aquello de lo que hablamos. Conservarlo es una apuesta nuestra; la literatura, hoy, no está de nuestro lado.[11]
La paciencia de las tres de la madrugada
El tercero es el refuerzo sin fricción. Un asistente de IA es, con cada usuario, así: contesta a las tres de la madrugada, no suspira en la séptima revisión y no guarda rencor si le gritan. Paciencia sin techo, disponibilidad sin horario, atención puesta por completo en quien pregunta, sin réplica, sin rencor, sin cansancio. Históricamente esa forma de relación la vivieron poquísimas personas, y las sociedades tenían nombres reservados para ella: médico de cámara, preceptor, ayuda de cámara. Hoy es cotidiana para cualquiera, decenas de veces al día. Si la teoría del punto de referencia es correcta, esa rutina dejará rastro: expectativas más altas sobre el margen de error de quien trabaja de cara al público, menos tolerancia a la fricción con compañeros y familia, «que lo atienda una persona» pasando de opción por defecto a mejora de pago, y un umbral más bajo para escalar una queja. Toda esa serie es inferencia, no conclusión verificada.
El condicionamiento requiere repetición, retroalimentación inmediata y bajo coste. La que dan las personas siempre trae fricción: hay que esperar, hay que leer la cara del otro, hay que devolver el favor. La IA cumple las tres condiciones sin ninguna de esas contrapartidas. Cuando el lado sin fricción se convierte en el conjunto de entrenamiento principal, el umbral de tolerancia a la fricción debería bajar. Ese es el razonamiento. La evidencia es bastante más blanda que el razonamiento.
El equipo de Fang puso a 981 personas a hablar con ChatGPT durante cuatro semanas, más de 300.000 mensajes. De las condiciones que ellos habían dispuesto (texto o voz, asuntos personales o impersonales) no salió nada. Lo que sí salió fue algo que no habían dispuesto: cuanto más hablaba alguien al día, más soledad declaraba, menos vida social presencial tenía, más dependía del sistema y menos capaz era de parar. Hablar mucho lo eligieron ellos, así que esto es correlación, no causalidad, y el uso fue autoseleccionado; los efectos son muy pequeños, con β entre 0,02 y 0,06; y lo que usaban era ChatGPT de propósito general con una tarea diaria asignada, no una app de compañía, que no se probó. El artículo sigue siendo un preprint, sin revisión por pares.[12]
Y entonces la evidencia se da la vuelta. De Freitas y colegas, en varios estudios publicados en 2026 en el Journal of Consumer Research, encuentran que los acompañantes de IA reducen la soledad, con una magnitud comparable a la interacción humana y superior a actividades como ver vídeo. Smith, Bradbury y Karney, en su revisión de la ciencia de las relaciones publicada en 2025 en Perspectives on Psychological Science, lo dicen aún más claro: la base empírica sobre los efectos posteriores de la IA en las relaciones humanas está en gran medida ausente.[13] Ninguno de los dos lados ha medido lo que importa. Hasta hoy, ningún experimento ha medido nunca cómo cambian, tras la exposición a la IA, las expectativas de una persona respecto de parejas humanas o de trabajadores de servicios humanos. Este mecanismo es hoy una hipótesis, no un hallazgo, y el más blando de los tres. Lo conservamos porque los otros dos preguntan cómo cambia el contenido y solo este pregunta cómo cambia lo que una persona espera de otra, que es el paso en el que la deriva del estándar se convierte en dinero.
El compilador no es un amuleto
El trabajo del fontanero pasa una inspección, y a la inspección le da igual si el fontanero cae simpático; el del metrólogo pasa una calibración, y a la calibración le da igual el humor del cliente. Donde hay un control que un tercero puede hacer cumplir, el estándar no se lo lleva a hurtadillas el marco de referencia de nadie. Nosotros también nos creímos al principio que tener una prueba dura equivale a estar a salvo, y hasta nos pareció casi evidente. El programador junior lo desmintió. Tiene compilador, tiene pruebas unitarias, tiene incidentes en producción; tres controles, cada uno más duro que el anterior, todos ellos aceptación externa auténtica. Si algo falla, la máquina le dice en el acto en qué línea, sin que intervenga la simpatía de nadie. Según aquella regla debería estar protegido. No lo está. Esos tres controles la máquina los pasa más barato que él. Esa regla es falsa. La prueba no lo protegió: la prueba se convirtió en el salvoconducto de la máquina que vino a sustituirlo, porque un control que se puntúa solo es también un circuito donde una máquina puede entrenarse sola.
Hay que enunciarlo al revés: una prueba de aceptación protege al profesional solo en proporción a lo que le cuesta al sistema automatizado superarla. Compiladores, pruebas unitarias, pruebas actuariales de reservas, exámenes estandarizados: la máquina los supera a coste igual o menor que el humano, son anclas blandas y no protegen. Inspección en obra, responsabilidad por negligencia médica, visado estructural: superarlos exige presencia física, licencia y alguien que ponga su patrimonio encima de la mesa, son anclas duras y sí protegen.
Medir una ocupación se reduce entonces a dos preguntas. La primera: cuando el comprador dice «no es suficientemente bueno», ¿puede zanjarse la disputa sin recurrir a su conjunto de comparación? El fontanero contesta que sí, porque si la tubería gotea lo ve un tercero; la medicina estética se parte en dos: la mitad de la seguridad se zanja, y la de si queda bonito depende solo de la cara que el cliente lleva en la cabeza. La segunda: ¿puede un modelo actual producir de principio a fin el entregable aceptado, el entregable y no las tareas? Retocar una foto, sí; abrir con bisturí, no.
Cada pregunta se descompone en cuatro ítems binarios comprobables, puntuados de 0 a 4, y el detalle de la puntuación está en el manual de codificación del final. Cruzados los dos ejes salen cuatro celdas. Ese 2×2 es el esqueleto del esquema entero, y de él se lee todo lo que viene después.
| Anclado (AA alto) | Elástico (AA bajo) | |
|---|---|---|
| Automatizable (DA alto) | Anclado pero exprimido (fallan las anclas blandas: junior de software, actuarios, traducción general) | Elástico y automatizable (granjas de contenido, diseño de plantilla) |
| No automatizable (DA bajo) | Aislado (fontanería, metrología, funeraria, enfermería) | Elástico pero no automatizable (medicina estética, terapia, compañía, experiencia de lujo) |
Al mirar el cuadro dan ganas de añadir un tercer eje: cuánto depende el oficio de la estética, la emoción y el cuerpo. Nosotros lo dibujamos así en la primera versión y salió una segunda matriz. El deportista profesional la revienta él solo. Medido por dependencia emocional y corporal, el deporte profesional toca techo; pero quien arbitra es el marcador, una de las pruebas de aceptación externa más duras que existen, y por muy condicionado que esté el público, el resultado no se mueve. Que un mismo objeto caiga en extremos opuestos según cómo se defina el eje vertical demuestra que la dependencia no puede sustituir al mecanismo de arbitraje. Con las enfermeras y los cirujanos reconstructivos pasa exactamente lo mismo. Nuestra propia segunda matriz se equivoca en este punto.
Aun así, aquel dibujo había atrapado algo que este 2×2 no ve: quién fabrica el marco de referencia. Eso hay que dibujarlo, pero no como eje. Un eje solo lleva magnitud, y esto es un flujo con dirección.
El fotógrafo de bodas explica por qué. Su porfolio de este año es la referencia de la novia del año que viene; la novia le exige un resultado físicamente imposible y paga por él; y mientras tanto su línea de retoque ya está automatizada. Una sola persona ocupa a la vez las posiciones de emisor, beneficiario y exprimido. El papel va pegado a la línea de ingreso, y solo por ahí puede codificarse.
| Posición en el bucle | Significado | Líneas de ingreso típicas |
|---|---|---|
| Emisor | Su salida circula como material de referencia de otros mercados | modelos de imagen, plataformas de filtros, VTubers, microdrama con IA, apps de compañía |
| Beneficiario | El estándar desplazado supera lo que el canal barato puede suministrar físicamente y la demanda migra aquí | medicina estética, spa de alta gama, terapia, servicios de compañía |
| Exprimido | El estándar se desplazó y el entregable es automatizable | ilustradores, desarrolladores junior, traductores generalistas |
| Aislado | Aceptación anclada; no participa en el juego del marco de referencia | fontanería, metrología, funeraria, mantenimiento de ascensores |
La solución, por tanto, es conservar un único 2×2 y dibujar lo que vio la segunda matriz como flechas entre las celdas. Los emisores fabrican el marco de referencia; el marco golpea a la vez al beneficiario y al exprimido, y en el primero sube la demanda mientras en el segundo sube el estándar y se automatiza su propio trabajo. El aislado no está en esa cadena: ninguna flecha lo toca. Las cuatro posiciones son cuatro eslabones de una misma cadena, y la producción de cada uno es la entrada del siguiente. Fundir las dos matrices no aporta nada más que este juego de flechas.
Los ocho que no se dejan puntuar
El esquema pasó una prueba de resistencia con 18 sectores, y 10 de las 18 filas llevan una señal de aviso. En 8 de ellas, alrededor del 44%, lo inestable es la codificación misma: medicina estética, tatuaje, agencias de VTubers, radiólogos, fotografía de bodas, actuarios, entrenadores personales y arquitectos de firma. Las otras dos filas se codifican de forma estable y su problema está en otra parte: el programador junior refutó la regla de más arriba y en los servicios de compañía no hay manera de fijar la dirección. Donde el esquema no acierta a puntuar es donde se acaba la evidencia. El primer caso es la medicina estética, y da la casualidad de que el caso insignia es el peor codificado. La mitad de la seguridad puntúa 4: si algo sale mal hay licencia, hay historia clínica, hay responsabilidad, se indemniza y existen precedentes sobre cuánto. La mitad de la satisfacción puntúa 0: que el resultado sea bonito no lo arbitra nadie desde fuera, el único juez es la cara que el cliente lleva en la cabeza, y esa cara se retocó anoche en un teléfono. En la misma clínica y en la misma operación, las dos mitades reciben fuerzas de sentido contrario: la de la seguridad está cada vez más reglada y la de la satisfacción cada vez más suelta. La mitad que el médico puede demostrar y la mitad que al cliente le importa conviven en el mismo consentimiento informado sin que ninguna mande sobre la otra. Para darle una celda hay que decidir antes a cuál de las dos se hace caso.
Los cuatro siguientes se pueden contar juntos. Las agencias de VTubers son legalmente sustituibles por IA, y sin embargo los seguidores pagan una prima porque detrás de esa identidad haya alguien; los arquitectos de firma tienen estándar elástico y alta automatizabilidad, deberían estar exprimidos según el esquema y en la práctica los protege el prestigio. Cuando un mismo parche arregla dos celdas, lo que falta no es un parche sino una variable. Esa variable es la prima de procedencia: hay quien paga por que la cosa la haya hecho una persona. Si es estable o no es una cuestión empírica abierta que la matriz no puede zanjar. El radiólogo y el actuario tropiezan en el mismo sitio: lo primero que los frena es el permiso. La lectura de imágenes y las pruebas de reservas ya están llamando a la puerta, y la norma sigue exigiendo la firma de una persona con nombre. Estas celdas marcadas «con barrera regulatoria» son las que cambian más deprisa y las de mayor varianza; hay que señalarlas aparte y no promediarlas.
Queda el acompañamiento, que es el límite duro del esquema. Si la compañía con IA es complemento (eleva la línea base afectiva y empuja hacia los servicios humanos) o sustituto (satisface la necesidad dentro del propio canal) no lo deciden los dos ejes: es exógeno. Por eso, para los servicios de alto condicionamiento y baja automatizabilidad, damos magnitud pero no dirección, hasta que la complementariedad se mida por separado.
| Sector | AA | DA | Bucle | Estabilidad |
|---|---|---|---|---|
| Medicina estética | seguridad 4 / satisfacción 0 | 1 | Beneficiario | ⚠ caso insignia, peor codificación |
| Tatuador | 1 | diseño 3 / aplicación 0 | Emisor+Beneficiario / Exprimido | ⚠ rol doble, hay que dividir |
| Fontanero | 4 (dura) | 0 | Aislado | estable |
| Dentista | restaurativa 4 / estética 1 | 0 | Aislado (con cola beneficiaria) | estable |
| Agencia de VTubers | 0 | 3, pero con prima de procedencia | Emisor | ⚠ véase abajo |
| Programador junior | 2–3, ancla blanda | 4 | Exprimido | ⚠ refuta la regla anterior |
| Radiólogo | 4 (dura) | capacidad 4 / con barrera | pendiente | ⚠ máxima varianza |
| Traductor | jurada 3 / general 0 | 4 | Con barrera / Exprimido | estable |
| Fotógrafo de bodas | 0 | captura 1 / edición 4 | los tres roles a la vez | ⚠ hay que dividir |
| Enfermería | 4 (dura) | 0 | Aislado | estable; véase la predicción |
| Conserje de hotel de lujo | 0 | presencia 0 / información 4 | Beneficiario / Exprimido | estable |
| Actuario | 3–4, ancla blanda | con barrera | pendiente | ⚠ riesgo de ancla blanda |
| Entrenador personal | 1 (discutible 2) | programación 3 / presencia 0 | Beneficiario / Exprimido | ⚠ caso de banda en disputa |
| Director funerario | 3 | 0 | Aislado | estable |
| Arquitecto de firma | estructura 4 / diseño 0 | concepto 4 / visado con barrera | Emisor+Beneficiario | ⚠ inversión por prestigio |
| Servicios de compañía | 0 | 0 | Beneficiario | ⚠ signo indeterminado |
| Deportista profesional | 4 (la más dura) | 0 | Emisor | estable |
| Redactor de granja de contenido | 0 | 4 | Exprimido | estable pero sobredeterminado |
Qué solidez tiene el caso insignia
Para que el lado beneficiario exista de verdad tiene que haber alguien pagando en ese extremo. La medicina estética es el tramo con más datos de toda la cadena. Su evidencia es más débil de lo que casi todo el mundo supone, y su estructura interna, más desordenada que el relato habitual.
La referencia más sólida que hay sobre el asunto es un metaanálisis de tres niveles publicado en 2026 en Mass Communication and Society. Entre usar redes sociales y plantearse una cirugía estética hay una correlación de r = 0,21, que se amplifica cuando el uso gira en torno a la apariencia. Es una correlación, y de tamaño pequeño a moderado.[14]
Los datos del sector aportan un detalle que va en sentido contrario. La encuesta global de la Sociedad Internacional de Cirugía Plástica Estética de 2024 registra un crecimiento acumulado de alrededor del 42,5% en cuatro años, pero 2024 cayó respecto de 2023: los procedimientos quirúrgicos un −6,7% y los no quirúrgicos un −3,1%. Si la demanda impulsada por el condicionamiento fuera monótona, esa caída pediría explicación.[15] Nuestra lectura es que el giro de ese año tiene que ver sobre todo con el precio y el crédito, y que la deriva del marco de referencia es una variable lenta, tan lenta que en la curva de un solo año no se ve. Esa lectura no la podemos demostrar: sobre los datos de 2024 es indistinguible de la hipótesis de que el condicionamiento no esté empujando la demanda en absoluto. Lo único seguro es que «la IA reescribe los cánones de belleza, luego la demanda estética se dispara» es una narrativa demasiado simple, y que el ciclo macroeconómico, el precio y la regulación probablemente pesan más que la deriva del marco de referencia.
Hay además una atribución que corregir. La «dismorfia de Snapchat» no la acuñó JAMA Facial Plastic Surgery. Su primera aparición en la literatura revisada por pares es un editorial de Ramphul y Mejias publicado en Cureus en marzo de 2018; la prensa, por su parte, atribuye la acuñación al médico estético británico Tijion Esho. El texto de Rajanala, Maymone y Vashi es un artículo de opinión, y su función fue medicalizar y popularizar un término que ya circulaba: su propia redacción dice «dubbed» («llamado así»). Esto corrige un error de una versión anterior de este artículo.[16]
La cifra del 55% hay que rebajarla. El conocido «el 55% de los cirujanos encuestados había atendido a pacientes que buscaban verse mejor en los selfis, frente al 42% del año anterior» procede de una nota de prensa de la encuesta anual de miembros de la Academia Estadounidense de Cirugía Plástica Facial y Reconstructiva (AAFPRS). El marco muestral son cirujanos miembros de la asociación y la respuesta es voluntaria; el tamaño de muestra, la tasa de respuesta y el método de muestreo nunca se han publicado, y tampoco existe un documento revisado por pares equivalente. Sirve como indicio de que el fenómeno ocurre; no sirve en absoluto como tasa poblacional.
«El trabajo emocional se encarece» no tiene evidencia hoy. The Managed Heart, de Hochschild, estableció en 1983 el concepto de trabajo emocional, y hay trabajo revisado por pares que documenta el aumento de la incivilidad del cliente: las comparaciones de antes y después de la COVID muestran que el efecto indirecto de esa incivilidad sobre el desempeño, por la vía del agotamiento emocional, se ha vuelto más marcado. Pero no encontramos ni un solo estudio que establezca que la exposición a la tecnología o a la IA eleve las expectativas del cliente respecto de proveedores humanos. Esta inferencia solo puede presentarse como hipótesis con un diseño de investigación adjunto, nunca como hallazgo establecido.
El mismo asunto arrastra además un desfase geográfico. La demanda nueva que ya crece en las zonas de adopción densa tiene esta forma: peticiones para devolver a una cara filtrada por IA su aspecto real, desenganche del acompañamiento con IA y reparación de vínculos humanos, prima por el contenido escrito por personas y por la identidad humana verificada, y formación en gestión de expectativas para quienes trabajan del lado beneficiario. Lo que en las zonas de adopción escasa todavía no se ha revalorizado es el precio de la celda aislada. Este párrafo descansa en un supuesto sin contrastar: que CCAA se difunde al mismo ritmo que la adopción de la IA. Es muy posible que sea falso, porque los efectos cognitivos viajan por el contenido y el contenido circula a escala nacional, no por gradiente geográfico. Úselo como hipótesis, no como plan.
Cómo sabríamos que nos equivocamos
Escribimos en su momento tres condiciones de refutación y, pensadas una a una, ninguna se sostiene. La primera era contar qué proporción de imágenes de IA hay entre las fotos de referencia que los pacientes llevan a las clínicas estéticas, y ya de entrada no hay denominador, ni línea base, ni umbral. Las clínicas no archivan imágenes de referencia y el consentimiento impide recogerlas de forma retrospectiva; y aunque se consiguieran, la detección de IA sobre imágenes sociales comprimidas está tan mal calibrada que no sirve. Además, la proporción de IA en toda la oferta de imágenes sube de todos modos: ver que un paciente trae una foto retocada con IA solo prueba que existen fotos retocadas con IA.
La segunda era preguntar a los usuarios intensivos de apps de compañía si les ha bajado la tolerancia a la fricción, y ahí hay pared por tres lados. Quienes adoptan se autoseleccionan por la pendiente, de modo que controlar la soledad de partida no lo resuelve; si se les pide que lo declaren ellos, la vara con la que miden ya se ha movido junto con lo que se quiere medir; y ni siquiera el signo está fijado, porque un uso terapéutico bien podría elevar la tolerancia.
La tercera era medir el cambio de registro en la escritura laboral. Eso sí se puede medir, solo que mide otra cosa: causalidad inversa, factores de confusión en la misma ventana temporal, ausencia de grupo de control, no falta ni uno de los problemas clásicos. Y al final solo se demuestra imitación y difusión. De los tres mecanismos, el del registro es el que tiene más material, y se atasca exactamente en el mismo sitio.
El diseño que sí funciona consiste en esto. Tome 40 correos y memorandos escritos por personas en 2019 y no cambie ni una palabra. Cada año, una cohorte nueva de mandos que nunca los ha visto juzga esos mismos textos con la misma rúbrica: «aceptable para enviar» frente a «exigiría revisión». Como el estímulo es constante por construcción, cualquier deriva solo puede venir del estándar.[17]
El diseño sortea todo aquello contra lo que se estrellaban las tres condiciones anteriores: el estímulo no se mueve, solo se mueve la vara. Es la línea que separa un esquema de un hallazgo. Y se traslada igual a otros dominios: paneles de rostros congelados para la medicina estética, transcripciones congeladas para el acompañamiento, paneles de texto congelado para el trabajo, con una prueba de dosis-respuesta entre dominios de distinta exposición a la IA. Tampoco cuesta mucho: una ronda al año, cuarenta materiales y un grupo de evaluadores dispuestos a sentarse a leerlos enteros. Hasta que esa gente entregue sus hojas, cada cifra de este artículo es una hipótesis.
Hay otra prueba todavía más barata, y está a la vista en la misma tabla de dieciocho filas: la enfermería. Lo que hace el personal de enfermería es auditable y aproximadamente constante: cuántas veces se cambia de postura a un paciente, en cuántos segundos se acude a un timbre, cuántas comprobaciones se hacen antes de administrar un fármaco. Todo eso queda registrado y no cambia de un año a otro. Si a los pacientes les reajusta el marco de referencia un chatbot infinitamente paciente, entonces, con esa práctica inalterada, las puntuaciones de satisfacción del paciente (en Estados Unidos, los instrumentos del tipo HCAHPS) deberían descender año tras año. Práctica constante, valoración a la deriva: eso es una medición de umbral lista para usar. Las tablas de puntuación son públicas, las descarga cualquiera y ni siquiera hace falta reunir cuarenta cartas. Solo falta un acontecimiento externo: que sean los pacientes quienes se pongan a usar el chatbot. Y está ocurriendo, a velocidades distintas según la región y la edad, lo que da una diferencia de dosis natural. Si la práctica no cambia y las puntuaciones de las enfermeras tampoco se mueven año tras año, este artículo se equivoca.
Dos preguntas
Este esquema no predice niveles de empleo. El empleo de un sector lo dominan la demanda, la demografía, el precio y la regulación, y el condicionamiento es apenas un residuo pequeño; usar este 2×2 para calcular cuántos puestos tendrá un sector dentro de unos años es un mal uso. Predice solo la dirección de la deriva del estándar, y consecuencias duraderas únicamente allí donde ocurre la codificación institucional. Para los servicios de alto condicionamiento y baja automatizabilidad, con el acompañamiento como caso típico, solo puede dar magnitud, no dirección.
Lo que uno se lleva son dos preguntas, y cualquiera puede hacérselas sobre su propio oficio. ¿Quién arbitra si lo hago bien: un documento con efectos legales o la impresión de alguien? Y para pasar esa prueba, ¿a una máquina le sale más caro o más barato que a mí? Solo respondiendo a las dos se sabe en qué celda está uno. Quien no ve la segunda mitad termina concluyendo que la IA no puede hacer su trabajo y que por tanto está a salvo. Eso es lo que piensa buena parte del lado beneficiario, que se enfrenta a un marco de referencia en plena reescritura. Y al revés: saber si un trabajo está protegido de verdad es preguntar por el otro extremo del mismo asunto, esto es, cuánto le cuesta a una máquina pasar esa prueba de aceptación. Si la prueba existe y la máquina la pasa barata, esa prueba es la puerta por la que entra el reemplazo.
Lo demás es medir, y no sale caro: una cohorte de evaluadores al año, cuarenta textos viejos que nadie toca y una tabla de puntuaciones que ya es pública. Este artículo es un vocabulario y un conjunto de hipótesis por contrastar, y lo seguirá siendo hasta que el panel de deriva con estímulo congelado dé sus primeros datos. El problema del ostrero nunca estuvo en el pájaro, sino en aquel huevo fabricado a propósito; y si estas máquinas están poniendo huevos así, las primeras en verlo serán las puntuaciones de las enfermeras y aquellas cuarenta cartas.
Apéndice I: sobre el término
El término fue acuñado y definido por TopXEA Research y se publica por primera vez en este artículo, con fecha 1 de septiembre de 2026. Cita sugerida: TopXEA Research (1 de septiembre de 2026). CCAA: la IA no te sustituye, reescribe tus normas. TopXEA. https://topxea.com/es/blog/ccaa-cognitive-conditioning-ai-applications
«Condicionamiento» se usa aquí en su sentido coloquial, no en el técnico. En psicología, «cognitive conditioning» ya está ocupado: pertenece a la familia del condicionamiento encubierto desarrollada por Cautela y designa aprendizaje asociativo, con estímulo condicionado, estímulo incondicionado y refuerzo. El mecanismo que describimos no es aprendizaje asociativo: no hay EC, no hay EI, no hay programa de refuerzo. Es recalibración psicofísica del punto de referencia, es decir, la teoría del nivel de adaptación de Helson, la teoría de rango-frecuencia de Parducci y los experimentos de Levari y colegas de 2018. Conservamos la palabra porque en lenguaje corriente transmite con exactitud lo que queremos decir, algo lento, prolongado e inadvertido; en contexto académico, léase el mecanismo tal como se describe en este párrafo y no según la teoría del aprendizaje.
El acrónimo colisiona con demasiadas cosas. CCAA arrastra al menos una veintena de sentidos en otros campos, y el dominante es la Companies' Creditors Arrangement Act canadiense. Eso vuelve a CCAA prácticamente inservible como término de búsqueda: en textos formales conviene escribirlo completo, o como «CCAA (condicionamiento cognitivo)». Reivindicamos la definición, no la propiedad de tres palabras en inglés; si alguien ha usado antes esta expresión con el mismo sentido o uno parecido, envíenos la fuente y la añadiremos aquí cediendo la prioridad. Basta un enlace, no hace falta convencernos.
Apéndice II: manual de codificación
Cada eje se descompone en cuatro ítems binarios, ocho en total, puntuados de 0 a 4. Los ítems se redactan como juicios de hecho comprobables y nunca como juicios de grado, para que tres personas que codifiquen por separado puedan coincidir. Los cuatro del anclaje de la aceptación: existe una especificación escrita y exigible por un tercero (norma legal, código técnico, guía clínica, SLA numérico); existe un evento de aprobado o suspenso observable por un tercero en un tiempo acotado (inspección, ensayo, la tubería gotea o no); el fallo acarrea responsabilidad con independencia de la satisfacción (licencia, negligencia profesional, responsabilidad penal); el pago o la renovación dependen de esa prueba y no de una valoración de satisfacción. Anclado ≥3; elástico ≤1; =2 es banda en disputa, se informa como inestable y nunca se fuerza a un lado.
Los cuatro de la automatizabilidad del entregable: el entregable se transmite como bits, sin manipulación física del cuerpo o la propiedad del cliente en el momento de la entrega; al menos el 70% de los ítems de tiempo de tarea de O*NET de la ocupación son ejecutables por un modelo al coste actual; no hay requisito legal de firma o presencia humana, y no existe una disposición a pagar medible condicionada a la autoría humana; no hay responsabilidad, o es asegurable sin una persona nominal. Alto ≥3; bajo ≤1; =2 entra igualmente en la banda en disputa. La corporeidad vive en el ítem 1 de este eje y solo ahí: es una razón por la que el entregable resiste la automatización, no una razón por la que el estándar resista la deriva. Contarla una sola vez es lo que impide que los dos ejes se copien la respuesta. La prima de procedencia se registra aparte, como modificador, y mide si existe una disposición a pagar medible por la autoría humana como tal. De ella dependen los ingresos de las agencias de VTubers y de los arquitectos de firma, y como esa propiedad no tiene sitio en ninguno de los dos ejes hay que colgarla fuera, codificarla y reportarla por separado. Su valor cambiará probablemente con el tiempo, así que debe anotarse junto con el año.
Las reglas de codificación son cuatro. Divida las líneas de ingreso antes de codificar: si dos líneas difieren en ≥2 en anclaje o en automatizabilidad, la ocupación se representa como segmento y no como punto, y se pondera por ingresos; medicina estética, tatuaje y fotografía de bodas lo exigen. Con anclaje = 2, pregunte quién paga el fallo: penalización establecida e independiente del humor del cliente, anclado; el cliente solo se culpa a sí mismo, elástico. Con automatizabilidad = 2, pregunte qué se rompe antes, la capacidad o el permiso: si es el permiso, codifique bajo y etiquete «con barrera regulatoria», porque esas celdas cambian más deprisa y son las de mayor varianza, y hay que señalarlas en lugar de promediarlas. La matriz se recodifica una vez al año y lo que se informa es la variación, con el nivel como subproducto: la automatizabilidad no es constante y una matriz sin fecha se pudre.
El protocolo de fiabilidad es este: ocho ítems binarios, tres codificadores independientes, una muestra de 40 ocupaciones, objetivo Krippendorff α ≥ 0,7 y publicación de la lista de desacuerdos en lugar de un α global. Saber en qué ocupaciones y en qué ítems se produjo el desacuerdo es mucho más útil que una cifra total.
Notas
- Hui, Reshef y Zhou, 2024, Organization Science 35(6):1977–1989: en una plataforma de trabajo autónomo, las ocupaciones muy expuestas perdieron en torno al 2% de encargos y el 5,2% de ingresos mensuales, sin evidencia de que un buen historial protegiera a nadie. Demirci, Hannane y Zhu, 2025, Management Science: en ocho meses, las ofertas cayeron alrededor del 21% en trabajos de escritura y programación automatizables y en torno al 17% en creación de imágenes tras la aparición de la IA generativa de imagen; las ofertas supervivientes eran más complejas y mejor pagadas.
- «Canarios en la mina», de Brynjolfsson, Chandar y Chen, revisión de agosto de 2026, con datos administrativos de nóminas de ADP: un déficit relativo de empleo de en torno al 19% entre los trabajadores de 22 a 25 años en las ocupaciones más expuestas. Brynjolfsson, Li y Raymond, 2025, Quarterly Journal of Economics 140(2):889–942: 5.179 agentes de atención al cliente, con un aumento medio del 14% en casos resueltos por hora (no el 15% que suele citarse), del 34% entre novatos y casi nulo entre veteranos de alto rendimiento. Noy y Zhang, 2023, Science 381(6654):187–192, ensayo aleatorizado preinscrito: 453 profesionales con formación universitaria, con una caída del 40% en el tiempo de escritura y una mejora del 18% en la calidad.
- Eloundou y colegas, 2024, Science 384(6702):1306–1308. De paso, una corrección al error de cita más común de esta literatura: el famoso «80% de los trabajadores con al menos el 10% de sus tareas afectadas y 19% con al menos la mitad» procede de su preprint de arXiv de 2023 y no del artículo de Science; no deben citarse juntos. El indicador AIOE de exposición por capacidades, de Felten, Raj y Seamans, 2021, Strategic Management Journal. El documento de trabajo de Webb, de 2019, sigue hoy sin publicarse formalmente.
- Acemoglu, 2025, Economic Policy 40(121); Autor, 2024, documento de trabajo NBER 32140.
- Levari y colegas, 2018, Science 360(6396):1465–1467. Las fuentes del linaje teórico: Helson, 1964, Adaptation-Level Theory; Parducci, 1965, Psychological Review 72(6):407–418; Festinger, 1954, Human Relations 7(2):117–140; Gerbner y Gross, 1976, Journal of Communication 26(2):172–199.
- Jakesch y colegas, CHI 2023: 1.506 participantes; diferencia media de opinión en lo escrito de 0,29, d ≈ 0,5; desplazamiento actitudinal d = 0,22, p < 0,001 (doi:10.1145/3544548.3581196).
- Kobak y colegas, 2025, Science Advances 11(27) eadt3813: más de 15 millones de resúmenes de PubMed entre 2010 y 2024, inferido por el método de frecuencias léxicas en exceso. Liang y colegas, 2025, Nature Human Behaviour 9:2599–2609: 950.965 artículos.
- Hohenstein y colegas, 2023, Scientific Reports 13:5487, dos experimentos aleatorizados, n = 1.036.
- Brooks y colegas, 2020, Perspectives on Psychological Science 15(1):133–149.
- Doshi y Hauser, 2024, Science Advances 10(28) eadn5290: 293 escritores, 600 evaluadores; el efecto de homogeneización es de solo b = 0,871 (una idea de IA) y b = 0,718 (cinco) en una escala de similitud coseno de 0 a 100; la similitud se mide dentro de cada condición, esto es, cada relato contra el centroide de los demás de su propia condición, y no entre condiciones; el propio estudio no afirma ningún colapso de diversidad poblacional ni longitudinal.
- Ashkinaze y colegas, 2025, Proc. ACM Collective Intelligence Conference 198–213.
- Fang y colegas, 2025, arXiv:2503.17473: 981 participantes que lo completaron, 28 días, más de 300.000 mensajes, preinscrito en AsPredicted; diseño 3×3 de texto / voz neutra / voz cercana por tareas abiertas / impersonales / personales. Soledad β = 0,02, p = 0,027; socialización presencial β = −0,05, p = 0,0019; dependencia emocional β = 0,06, p < 0,001; uso problemático β = 0,02, p = 0,017.
- De Freitas y colegas, 2026, Journal of Consumer Research 52(6):1126–1148; Smith, Bradbury y Karney, 2025, Perspectives on Psychological Science 20(6):1081–1099.
- Metaanálisis de tres niveles publicado en 2026 en Mass Communication and Society: 24 estudios, 96 tamaños de efecto y una muestra total de 10.445 personas; r = 0,21, intervalo de confianza del 95% [0,13, 0,26].
- Encuesta global de la Sociedad Internacional de Cirugía Plástica Estética (ISAPS) de 2024: 37,9 millones de procedimientos, de los cuales 17,4 millones quirúrgicos y 20,5 millones no quirúrgicos.
- Editorial de Ramphul y Mejias, marzo de 2018, Cureus 10(3):e2263 (doi:10.7759/cureus.2263). El texto de Rajanala, Maymone y Vashi se publicó en JAMA Facial Plastic Surgery 20(6):443–444 (doi:10.1001/jamafacial.2018.0486).
- Especificación estadística del panel de deriva con estímulo congelado: el resultado principal es el efecto fijo de año sobre la probabilidad de exigir revisión en el mismo conjunto de textos invariables, con evaluadores ciegos y una cohorte nueva cada año. La identificación va por disponibilidad y no por uso, esto es, retiradas de funciones forzadas por reguladores y cambios de política de las tiendas de aplicaciones como choques exógenos, con diferencias en diferencias; también cabe un ensayo aleatorizado con diseño de incentivación, tomando el incentivo como variable instrumental. Toda escala autoinformada debe ajustarse con viñetas de anclaje, o el efecto de grupo de referencia contaminará la literatura entera.
Referencias principales
- Levari, D. E., Gilbert, D. T., Wilson, T. D., Sievers, B., Amodio, D. M., & Wheatley, T. (2018). Prevalence-induced concept change in human judgment. Science, 360(6396), 1465–1467. doi:10.1126/science.aap8731
- Helson, H. (1964). Adaptation-Level Theory. Harper & Row. / Parducci, A. (1965). Category judgment: A range-frequency model. Psychological Review, 72(6), 407–418.
- Brooks, K. R., et al. (2020). Looking at the Figures: Visual Adaptation as a Mechanism for Body-Size and -Shape Misperception. Perspectives on Psychological Science, 15(1), 133–149. doi:10.1177/1745691619869331
- Doshi, A. R., & Hauser, O. P. (2024). Generative AI enhances individual creativity but reduces the collective diversity of novel content. Science Advances, 10(28), eadn5290. doi:10.1126/sciadv.adn5290
- Ashkinaze, J., Mendelsohn, J., Qiwei, L., Budak, C., & Gilbert, E. (2025). How AI Ideas Affect the Creativity, Diversity, and Evolution of Human Ideas. Proc. ACM Collective Intelligence Conference, 198–213. doi:10.1145/3715928.3737481
- Jakesch, M., et al. (2023). Co-Writing with Opinionated Language Models Affects Users' Views. CHI '23, Article 111. doi:10.1145/3544548.3581196
- Kobak, D., et al. (2025). Delving into LLM-assisted writing in biomedical publications through excess vocabulary. Science Advances, 11(27), eadt3813. doi:10.1126/sciadv.adt3813
- Liang, W., et al. (2025). Quantifying large language model usage in scientific papers. Nature Human Behaviour, 9, 2599–2609. doi:10.1038/s41562-025-02273-8
- Hohenstein, J., et al. (2023). Artificial intelligence in communication impacts language and social relationships. Scientific Reports, 13, 5487. doi:10.1038/s41598-023-30938-9
- Fang, C. M., et al. (2025). How AI and Human Behaviors Shape Psychosocial Effects of Extended Chatbot Use. arXiv:2503.17473 (preprint).
- De Freitas, J., et al. (2026). AI Companions Reduce Loneliness. Journal of Consumer Research, 52(6), 1126–1148. doi:10.1093/jcr/ucaf040
- Smith, M. G., Bradbury, T. N., & Karney, B. R. (2025). Can Generative AI Chatbots Emulate Human Connection? Perspectives on Psychological Science, 20(6), 1081–1099. doi:10.1177/17456916251351306
- Eloundou, T., Manning, S., Mishkin, P., & Rock, D. (2024). GPTs are GPTs. Science, 384(6702), 1306–1308. doi:10.1126/science.adj0998
- Felten, E. W., Raj, M., & Seamans, R. (2021). Occupational, industry, and geographic exposure to artificial intelligence. Strategic Management Journal, 42(12), 2195–2217. doi:10.1002/smj.3286
- Hui, X., Reshef, O., & Zhou, L. (2024). The Short-Term Effects of Generative Artificial Intelligence on Employment. Organization Science, 35(6), 1977–1989. doi:10.1287/orsc.2023.18441
- Demirci, O., Hannane, J., & Zhu, X. (2025). Who Is AI Replacing? Management Science. doi:10.1287/mnsc.2024.05420
- Brynjolfsson, E., Li, D., & Raymond, L. (2025). Generative AI at Work. Quarterly Journal of Economics, 140(2), 889–942.
- Noy, S., & Zhang, W. (2023). Experimental evidence on the productivity effects of generative artificial intelligence. Science, 381(6654), 187–192. doi:10.1126/science.adh2586
- Acemoglu, D. (2025). The simple macroeconomics of AI. Economic Policy, 40(121). / Autor, D. H. (2024). Applying AI to Rebuild Middle Class Jobs. NBER WP 32140.
- Gerbner, G., & Gross, L. (1976). Living with Television: The Violence Profile. Journal of Communication, 26(2), 172–199. / Festinger, L. (1954). A theory of social comparison processes. Human Relations, 7(2), 117–140.
- Ramphul, K., & Mejias, S. G. (2018). Is "Snapchat Dysmorphia" a Real Issue? Cureus, 10(3), e2263. doi:10.7759/cureus.2263 / Rajanala, S., Maymone, M. B. C., & Vashi, N. A. (2018). Selfies—Living in the Era of Filtered Photographs. JAMA Facial Plastic Surgery, 20(6), 443–444. doi:10.1001/jamafacial.2018.0486
- Hochschild, A. R. (1983). The Managed Heart: Commercialization of Human Feeling. University of California Press.
Term provenance: the term Cognitive-Conditioning AI Applications (CCAA) was coined and defined by TopXEA Research, first published in this article on 1 September 2026. In this article "conditioning" is used in its everyday sense of habituation and baseline recalibration, not in the technical sense of associative or covert conditioning.
Riesgo y descargo de responsabilidad: este artículo es una discusión conceptual y metodológica. No constituye asesoramiento de inversión, orientación profesional ni consejo médico, y no se dirige a ninguna organización o persona concreta. La investigación externa citada indica su fuente y su grado de evidencia; los pasajes marcados como «inferencia» o «hipótesis» son juicios nuestros y no están verificados. Operar conlleva riesgo, todo EA y toda estrategia cuantitativa pueden perder dinero, y el trading de divisas y metales preciosos es de alto riesgo: opere solo con dinero que pueda permitirse perder.